|
|
 |
|
|
 |
|
 |
|
|

|
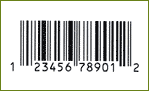
UPC CODE는 식료품 관련협회인
Ad Hoc 위원회가 설립된 이래로 식료품과 잡화 등
유통 제품에 부착하기 위한 연구 결과로 컴퓨터와 POS(Point
of Sales) 제작에 흥미를
가졌던 많은 제작자들이 여러 제안에 의해 Battle
Memorial 연구소와 그래픽 기술 재단에서
인쇄 내성(Printing Tolerance) 및 인쇄
능력 시험과 상점에서의 시험등을 거쳐 대량의
심벌에 대한 평가 연구를 시작으로, 마침내 1973년
4월3일 산업 부문 표준 심벌로 채택되었다.
이 심벌은 IBM에서 고안한 것과 거의 유사한 것이며
현재 미국이나 캐나다 등지에서
POS용으로 백화점이나 슈퍼마켓의 식료품과 일상 잡화,
의료제품 등에 사용되고 있다. |
|
 |
|
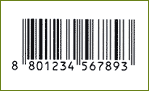 |
EAN CODE는 미국의 UPC 코드 제정 이후에
유럽의 12개국이 모여서 국제적인 공통 상품
코드를 1977년에 제정했는데, 이것이 바로 EAN(European
Article Number) 코드이다.
EAN 코드는 UPC 코드보다 상위 레벨의 코드로 EAN
코드를 판독할 수 있는 판독기는
UPC 코드를 읽을 수 있으나 그 반대는 성립되지 않는다.
WPC(WorldProduct Code) 또는 IAN(International
Article Number) 이라고도 알려져 있으며,
UPC와 같은 기호로 구성되어 있다.
EAN 코드는 13개의 문자를 포함할 수 있는 데 바코드로
표현하는 것은 12자리이고,
맨좌측의 문자는 수치로 표현되므로 UPC와 동일한 심벌
길이인 95X를 갖는다. 또한, 맨 좌측
문자는 좌측의 6개 문자의 패리티 패턴을 결정하고 패턴
세트 B로 우측은 짝수 패리티로 표현한다. EAN 코드의
종류에는 EAN-13, 즉 13개의 문자를 포함하는 표준형과
EAN-8인 8개의 문자를
포함하는 단축형이 있다. EAN과 UPC의 차이점을 보면
우선 UPC 코드는 6자리나 11자리로
구성되어 있으며, EAN은 8자리나 13자리로 구성되어
있다. UPC와 달리 좌측 여백, 좌측
가드패턴, 국각 번호, 제조업체 번호, 중앙 가드패턴,
제품 번호, 검증 문자로 구성된다.
UPC 심벌이 한 자리의 상품 분류 체계 번호와 5자리의
제조업체 번호로 좌측 6자리를
표현하는 데 EAN 심벌은 세 자리의 국가 번호와 네
자리의 제조업체 번호로 좌측 7자리를
표현한다. (단, 바코드로 표현되는 것은 국각 번호 두
자리, 제조업체 번호 네 자리이다.)
EAN 코드의 각 캐릭터는 두 개의 바와 두 개의 여백으로
형성된 7개의 모듈로 이루어져
있으며 '0'은 밝은 모듈을 '1'은 검은 모듈을 나타낸다.
또한, EAN-8은 UPC 코드의
단축형(Version E)과 마찬가지로 소형 제품에 바코드를
부착하기 위해 고안된 것으로
8자리를 표현 할 수 있다. 맨 좌측의 가드 패턴은,
중앙의 가드패턴, 우측의 가드패턴은
표준형과 동일하며 좌측의 네 자리는 표준형의 패턴 A를,
우측의 네 자리는 표준형의 패턴
C를 사용하여 표현된다. 앞부분의 세 자리가 국가 번호이고,
제조업체 세자리, 상품 번호
한 자리, 검증 문자 한 자리로 구성된다. EAN 코드는
현재 협회 가맹국이 증가하여 전세계
약 50개 국가에달하고 있다. |
|
|
|
|
|
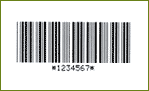 |
CODE39 CODE는 알파벳 문자를 코드화 할 수
있는 것의 대표적인 3 of 9 코드는 CODE
39로도 알려져 있다. 이 코드는 1974년 미국의 Interface
Mechanism(현재 Intermec 사) 의
데이비드 알리아스와 레이스티븐에 의해 개발되었다. 43개의
문자(0∼9, A∼Z, 7개의
특수문자)와 하나의 시작, 끝 문자로 구성되어 있으며
각 문자는 9개의 요소로 이루어지고
그 중 세 개는 논리값 '1'을 의미하며, 문자와 문자
사이의 갭은 코드값을 포함하지 않는다.
현재 공업용을 비롯하여 가장 널리 사용되고 있으며 보통
바 5개가 한 문자에 해당되며
시작과 끝 문자는 반시 '*'이어야 한다. |
|
|
|
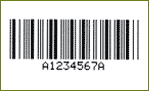 |
CODABAR CODE는 1972년 미국의 Monach
Marking System에서 백화점의 가격
표찰용으로 발표한 코드인데 각 캐릭터는 7개의 요소로
구성되어 있으며 네 개의 바와
세 개의 여백으로 이루어진다. 각 문자간의 여백은 어떠한
정보도 포함하고 있지 않다.
CODABAR의 각 캐릭터는 두 개의 넓은 바를 지니고
있기에 2 of 7 코드라고도 한다.
CODABAR로 표현 가능한 캐릭터는 숫자 0∼9, 6가지의
특수 문자 ($, -, :, /, ., +)와
네 가지의 시작과 끝 문자는(a/t, b/m, c/*,
d/e)를 가지고 있으며 이 시작/끝 문자는 다른
종류의 데이터베이스에 대한 키로 사용이 가능하다. 또한
6개의 특수 문자를 알파벳
A, B, C, D, E, F로 치환하여 16진수 입력을
가능하게 하므로 NW-7, Hex Code도
CODABAR의 일종이다. 이런 CODABAR는 주로
알파벳 문자는 필요하지 않으면서 가변되는
점을 이용해 혈액 위의 혈액팩, 도서관, 사진 현상 업무
등에 널리 사용되고 있다. |
|
|
|
|
|
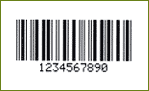 |
INTERLEAVED 2 OF 5 CODE는 2 of
5 코드류 중 가장 많이 사용되고 있는 이 코드는
1972년 미국의 Intermec사가 2 of 5 코드의
효율을 증대시키기 위해 개발했으며, 산업용
바코드 중에서 많이 이용된다. Interleaved 2
of 5 코드는 한 개의 숫자가 5개의 바와 5개의
스페이스를 교대로 조합시켜 이루어져 있으며 문자 사이의
갭을 없애 Industrial 코드에 비행
약 40%, Matrix 코드에 비행 약 10% 이상으로
길이를 줄일 수 있다. 다만, Interleaved 코드는
문자의 수가 짝수여야 하므로 홀수 개의 문자가 들어 왔을
경우 '0'이 맨 앞에 붙여지나
바코드 중 가장짧은 것이 특징이다. 이 코드는 숫자 데이터
표현시 많은 데이터를 짧게 코드화
할 수 있고 자체 감사 기능도 뛰어나므로 산업용 및 소매용으로
많이 사용된다. |
|
|
|
 |
CODE39 CODE는 알파벳 문자를 코드화 할 수
있는 것의 대표적인 3 of 9 코드는 CODE
39로도 알려져 있다. 이 코드는 1974년 미국의 Interface
Mechanism(현재 Intermec 사)의
데이비드 알리아스와 레이스티븐에 의해 개발되었다. 43개의
문자(0∼9, A∼Z, 7개의
특수문자)와 하나의 시작, 끝 문자로 구성되어 있으며
각 문자는 9개의 요소로 이루어지고
그 중 세 개는 논리값 '1'을 의미하며, 문자와 문자
사이의 갭은 코드값을 포함하지 않는다.
현재 공업용을 비롯하여 가장 널리 사용되고 있으며 보통
바 5개가 한 문자에 해당되며
시작과 끝 문자는 반시 '*'이어야 한다. |
|
|
|
|
|
 |
CODE128 CODE는 전체 ASCII 128 문자를
모두 표현할 수 있는 연속형 심벌로지이며,
수치 데이터는 심벌 문자당 두 자리로 표현한다. 1981년
Computer Identics Corp. 사에서
개발한 CODE 128은 현재 UPCSKS EAN등 데이터의
고밀도 표현을 요하는 여러 분야에서
응용, 사용되고 있다. CODE 128은 시작과 끝 문자,
변동 가능한 길이의 데이터, 바와 스페이스
두 개 모두에 대한 캐릭터 패리티, 체크 문자, 함수
문자 등으로 구성되어 있으며 인쇄가 보다
용이하며 현재 사용되고 있는 각종 컴퓨터, 프린터에 적당하다.
CODE 128의 심벌 구조는
좌우측 여백으로 인쇄돼지 않는 영역이 있고, 바코드화된
캐릭터의 연속은 단일한 시작 문자로
시작된다. 바로 옆에 가장 중요한 Most Significant가
오고 체크 문자 그리고 단일한 끝 문작 온다. CODE
128의 캐릭터 요소는 8개로 구성되며 각 요소들은 바
또는 바의 부분으로 이루어지면 각
캐릭터는 세 개의 바와 스페이스로 이루어진다. 각각의
바는 짝수 모듈(짝수 패리티)이고
스페이스는 홀수 모듈(홀수 패리티)로 이루어진다. 각
요소들의 폭은 1X, 2X, 3X, 4X의
네 가지로 바의 모듈은 '1'로, 여백의 모듈은 '0'으로
표시된다. 시작 문자는 세종류의 문자
패턴(A, B, C)이 있으며 끝 문자는 네 개의 바와
세 개의 스페이스, 여기에 두 개의 모듈과
종료 바(2)가 합쳐져 13개의 모듈(13X)로 구성된다.
CODE 128의 코드 구조는 A, B, C
세 가지 문자 집합이 있는데 심벌 시작문자가 A로 시작되면
코드 A의 집합으로 정의된다.
심벌의 중간에 전이 문자 (shift character)를
사용해 다른 문자 집합으로 옮길 수 있다.
문자 집합 A는 모든 alphanumeric 문자의 특수
문자, 컨트롤 문자를 포함하며 문자 집합 B는
모든 alphanumeric 문자와 특수 문자, 컨트롤
문자를 포함하는데 alphanumeric 문자들의
낮은 경우가 포함된다. 문자 집합 C는 00에서 99까지의
디지트쌍 100개와 특수 문자를 갖는데
문자마다 두 자리를 수치로 표현하므로 데이터의 밀도가
두 배이다. CODE 128에는 문자 집합
선택 문자(A, B, C), 전이 문자, 기능 문자가
모두 특수 문자로 존재하며, 한 개의 심벌 안에서
또는 한 개의 코드 부분 집합에서 다른 코드의 부분 집합으로
변화가 가능하다. |
|
|
|
|
|
|
|
|
|